

- Description
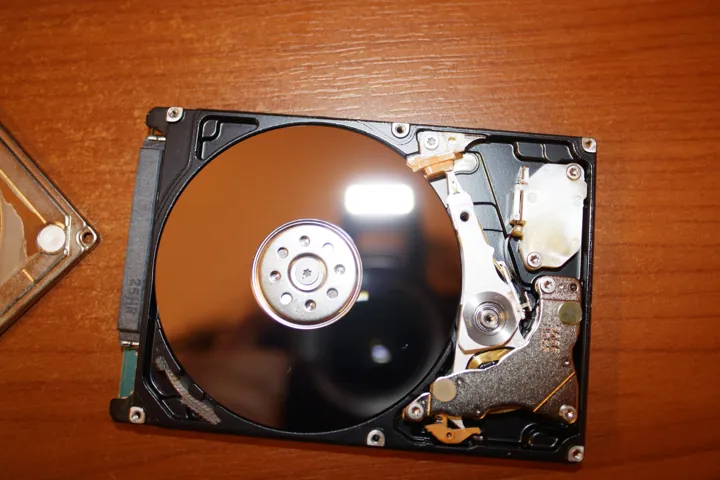
- Un disque dur ouvert, plateau et bras de lecture visibles, posé sur une table de bois.
- Source
- ViveaLiyevi · page d’origine
- Licence
- CC0 Domaine public
 Le biais de normalité
Parce que rien de grave ne s'est jamais produit, on en conclut que rien de grave ne se produira, et on ne se prépare pas.
En bref
- Quoi : on tient pour impossible, ou pour négligeable, un événement grave qu'on n'a jamais vécu, et on ne s'y prépare pas.
- Pourquoi : l'expérience passée passe pour une garantie ; l'imaginer coûte, s'en préparer coûte plus encore.
- Détecter : « ça n'est jamais arrivé », un plan de reprise jamais exercé, une sauvegarde jamais restaurée.
- Éviter : faire l'exercice pour de vrai, restaurer régulièrement, imaginer l'échec avant qu'il arrive, séparer les sauvegardes de la production.
Définition#
Le biais de normalité (normalcy bias) est la tendance à sous-estimer la probabilité et les effets d'une catastrophe, et à continuer à agir comme si la situation habituelle allait durer. Il est surtout décrit dans l'étude des réactions aux catastrophes : devant une alerte, certaines personnes ne bougent pas, interprètent les signes comme anodins ou attendent une confirmation. Les psychologues Haim Omer et Nahman Alon en proposent en 1994 une lecture comme « principe de continuité » : face à un événement, on cherche d'abord à y retrouver la continuité du monde connu, plutôt que d'accepter la rupture.
En informatique et en gestion, l'événement redouté est un incendie, une panne totale, une attaque qui chiffre tout, la perte d'un fournisseur, le départ soudain de la seule personne qui comprend un système. Le biais ne consiste pas à ignorer les risques (la plupart des équipes en ont une liste), mais à ne pas les traiter comme possibles : pas de test, pas de budget, pas de procédure.
Le biais de normalité est surtout documenté par des études de cas et des témoignages après catastrophe. Les chiffres souvent cités (« 70 % des gens figent devant un danger ») circulent sans source solide : cette fiche n'en retient aucun. Elle s'appuie sur des incidents d'exploitation bien documentés.
Le mécanisme#
- L'absence d'événement est prise pour une preuve. Dix ans sans incident majeur ne disent presque rien sur la probabilité d'un incident rare, mais donnent le sentiment d'un risque nul. C'est une forme d'induction fautive, proche du biais de disponibilité : ce qu'on ne se rappelle pas n'existe pas.
- L'imagination a un coût. Se représenter un site entièrement détruit est désagréable. Il est plus confortable de ranger l'idée parmi les scénarios « théoriques ».
- La préparation n'a pas de rendement visible. Une restauration testée ne produit rien tant que rien n'arrive ; elle concurrence des tâches qui, elles, avancent. Le coût est certain, le bénéfice hypothétique.
- Le besoin de continuité. Face à un signal d'alerte ambigu, on cherche d'abord l'explication la plus ordinaire (« une fausse alerte », « un incident passager »), ce qui retarde la réaction.
- La dilution de la responsabilité. Le plan de reprise appartient « à l'exploitation », la sauvegarde « à l'hébergeur », la sécurité « à l'équipe dédiée » : personne ne vérifie l'ensemble (voir l'effet spectateur).
Où on le rencontre#
En conduite de projet#
- Les sauvegardes jamais restaurées. La tâche planifiée s'exécute chaque nuit et signale « succès » ; personne n'a jamais essayé de remettre en service un système à partir d'elle.
- Les sauvegardes dans le même lieu. Copies, captures et réplicas sont stockés dans le même centre, la même baie, le même compte que la production : elles protègent d'une panne de disque, pas d'un incendie, d'un piratage ou d'une suppression de compte.
- Le plan de reprise « sur le papier ». Un document validé il y a trois ans, jamais exercé, dont les contacts et les mots de passe ont changé.
- Le fournisseur unique, la personne unique. Un composant, un prestataire ou un expert dont la défaillance arrêterait tout, sans plan B.
- Les alertes classées comme bruit. Un signal rare ou inhabituel est rangé avec les fausses alertes, parce que « c'est toujours comme ça ».
- L'environnement de production traité comme le test. Des commandes destructrices exécutées sans filet, parce que « cela s'est toujours bien passé ».
En management#
- Le budget de continuité sacrifié. En période de coupes, ce qui ne produit rien d'immédiat (exercices, redondance, documentation) est supprimé en premier.
- Le départ imprévu. L'équipe fonctionne grâce à une personne clé ; on n'organise pas la transmission, parce qu'elle « est là depuis toujours ».
- Les signaux faibles ignorés. Une équipe qui dit « nous sommes à la limite » n'est pas crue tant qu'aucun incident ne la confirme.
- La gestion de crise improvisée. Personne n'a décidé à l'avance qui décide, qui communique, qui appelle le client : les premières heures sont perdues.
Cas célèbres#
GitLab.com : cinq mécanismes de sauvegarde, aucun fiable 31 janvier - 1er février 2017#
Biais en jeu : biais de normalité, confiance dans des sauvegardes jamais éprouvées.
Ce qui s'est passé. Le 31 janvier 2017, un ingénieur de GitLab, qui tentait de rétablir la réplication de la base de données PostgreSQL, supprime par erreur le répertoire de la base principale. Environ 300 Go de données avaient déjà disparu quand la commande est interrompue. En cherchant à restaurer, l'équipe constate que les sauvegardes sur lesquelles elle comptait ne servent à rien : la sauvegarde standard échoue silencieusement parce que l'outil utilisé n'est pas de la même version que la base, et les notifications d'échec n'étaient pas parvenues à destination. Selon l'analyse publiée par GitLab, aucun des cinq mécanismes de sauvegarde ou de réplication en place ne fonctionnait de façon fiable ; la reprise s'est faite à partir d'une copie préparée six heures plus tôt pour un autre usage. Le service est resté indisponible environ 18 heures. Environ 5 000 projets, 5 000 commentaires et 700 comptes créés pendant la fenêtre perdue ont disparu ; les dépôts Git et les wikis, stockés ailleurs, n'ont pas été touchés. GitLab a diffusé en direct sa reprise et publié une analyse détaillée, qui reste un modèle de transparence.
Ce que cela illustre
Une sauvegarde qui ne s'est jamais restaurée est une hypothèse, pas une sauvegarde. Le rapport « succès » d'une tâche nocturne prouve que la tâche a tourné, pas que les données sont récupérables. Le réflexe d'évitement est un exercice de restauration régulier, avec mesure du temps réel, et une alerte qui prévient quand une sauvegarde échoue ou quand elle ne produit rien.
L'incendie d'OVHcloud à Strasbourg 10 mars 2021#
Biais en jeu : biais de normalité, sous-estimation d'un événement physique, sauvegardes colocalisées.
Ce qui s'est passé. Dans la nuit du 9 au 10 mars 2021, un incendie se déclare dans un des quatre centres de données d'OVHcloud à Strasbourg. Le centre SBG2 est détruit, SBG1 est endommagé en partie, SBG3 et SBG4 sont coupés. Selon la mesure de l'entreprise Netcraft, environ 3,6 millions de sites répartis sur 464 000 noms de domaine sont indisponibles, parmi lesquels des services publics, des banques en ligne et des boutiques. Pour une partie des clients, les données sont perdues pour de bon. Plusieurs d'entre eux ont constaté que leurs sauvegardes ou copies de sécurité se trouvaient dans le même site que les machines qu'elles devaient protéger, et ont perdu les deux. L'entreprise, de son côté, rappelait que la responsabilité de la sauvegarde hors site incombait aux clients selon le type d'offre souscrit.
Ce que cela illustre
« Notre hébergeur est sérieux » ne dispense pas de se demander ce qui reste si le site entier disparaît. La question utile n'est pas « est-ce probable ? » mais « sait-on repartir ? ». Une copie qui partage le même lieu, le même compte ou le même fournisseur que l'original est exposée aux mêmes événements. Les professionnels résument ce principe par la règle dite « 3-2-1 » : trois copies, sur deux supports, dont une hors site.
Signaux de détection#
- « Cela n'est jamais arrivé » ou « cela ne peut pas arriver ici » dans une discussion sur un risque.
- Le plan de reprise n'a pas été exercé dans les douze derniers mois, ou jamais en conditions réelles.
- Personne ne sait dire la date de la dernière restauration réussie ni le temps qu'elle a pris.
- Les sauvegardes sont chez le même fournisseur, dans le même site ou sous les mêmes identifiants que la production.
- Les risques « extrêmes » sont classés « improbables » sans estimation, et sans mesure de leur effet s'ils se produisent.
- Les alertes sont habituelles : on a cessé de les lire.
Réflexes d'évitement#
- Restaurer pour de vrai. À intervalle fixe, reconstruisez un environnement à partir des seules sauvegardes, mesurez le temps, notez ce qui manque. C'est la seule preuve qu'une sauvegarde sert.
- Séparer les copies de la production. Un autre site, un autre compte, un autre fournisseur ou au moins un autre domaine de panne. Une copie immuable ou hors ligne protège aussi d'une attaque.
- Faire un pré-mortem. « Imaginons que l'an prochain tout est arrêté depuis trois jours : que s'est-il passé ? » L'exercice fait émerger les scénarios que l'on se refuse à penser.
- Chiffrer en impact, pas en probabilité. Pour un événement rare, la question est « combien de temps, combien de données, combien d'argent ? ». Si la réponse est « l'entreprise s'arrête », le risque est traité même s'il est peu probable.
- Exercer le plan, y compris l'humain. Qui décide, qui prévient les clients, qui a les accès ? Un exercice de crise annoncé à l'avance, puis un exercice surprise.
- Surveiller l'absence de signal. Une sauvegarde qui ne produit rien, une alerte qui ne se déclenche jamais : traitez le silence comme une anomalie à vérifier.
- Rendre le résultat visible. Une date « dernière restauration validée » affichée sur le tableau de bord de l'exploitation, avec un responsable nommé.
Avec l'IA : détecter, remédier, atténuer#
L'IA est utile pour imaginer des scénarios qu'une équipe refoule et pour relire un plan de reprise sans complaisance. Elle ne teste rien : elle ne remplace ni une restauration réelle ni un exercice. Elle peut aussi paraître rassurante à tort en décrivant un plan « complet » sur le papier.
Détecter#
- Relire un plan de reprise et relever ce qui n'a jamais été vérifié ou testé.
- Repérer dans une architecture décrite les points uniques de défaillance et les copies colocalisées.
- Rechercher dans des comptes rendus les formules du type « cela n'est jamais arrivé ».
Remédier#
- Produire une liste de scénarios extrêmes propres au système décrit, avec leur effet.
- Rédiger un scénario d'exercice de restauration, avec critères de réussite.
- Proposer des mesures de séparation des sauvegardes (site, compte, support).
Atténuer#
- Utiliser l'IA pour un pré-mortem écrit, discuté ensuite en équipe.
- Lui faire jouer l'adversaire qui cherche comment tout détruire d'un coup.
- Faire valider ses propositions par ceux qui connaissent l'exploitation : elle ignore votre contexte.
Prompts à intégrer à vos usages#
1. Pré-mortem d'un incident majeur. À utiliser en comité de risques ou en préparation d'un plan de reprise.
Voici l'architecture d'un système (description anonymisée) : [composants, hébergement, sauvegardes, accès, dépendances].
Imagine que dans douze mois ce système est totalement indisponible depuis trois jours et que des données sont perdues.
Propose six causes plausibles et très différentes (physique, humaine, malveillante, fournisseur, organisationnelle, technique).
Pour chacune : ce qui a manqué pour l'éviter, ce qui aurait permis de repartir plus vite, et la vérification concrète à faire dès maintenant.
Ne rassure pas : signale ce qui n'est pas décrit dans mon texte.
2. Relecture critique d'un plan de reprise. À utiliser sur un plan de continuité ou de reprise existant.
Relis ce plan de reprise comme un auditeur sceptique.
1. Liste, pour chaque étape, ce qui n'a probablement jamais été testé.
2. Repère les copies de sauvegarde qui partagent un point commun avec l'original (site, compte, fournisseur, identifiants).
3. Indique les dépendances oubliées (accès, clés, contacts, licences).
4. Propose un exercice de restauration de deux heures, avec ce qu'il faut mesurer.
5. Dis en une phrase ce qui te semble le plus fragile.

Plan : [texte du plan, sans mot de passe ni donnée confidentielle]
Comment les intégrer#
- Avant l'exercice annuel : le prompt 1 prépare des scénarios plus variés que ceux que l'équipe choisit spontanément.
- À la revue du plan : le prompt 2 produit la liste des vérifications à faire, que l'on transforme en tâches planifiées.
- Après l'exercice : confrontez ce que l'IA avait prévu à ce que l'exercice a révélé, pour améliorer les prochains scénarios.
Précautions#
- L'IA ne prouve rien : seule une restauration réelle valide une sauvegarde.
- Ne collez jamais d'identifiants, de plans d'adressage ni de schémas de sécurité dans un outil non autorisé.
- Vérifiez les commandes et les références techniques qu'elle propose avant de les utiliser sur un système réel.
- Un plan « complet » rédigé par l'IA n'a aucune valeur tant qu'il n'a pas été exercé.
Limites#
- Le biais de normalité est plus décrit que mesuré : les statistiques de réaction aux catastrophes sont fragiles, et certains chercheurs jugent que le comportement des foules en crise est moins passif qu'on le dit.
- Ne pas se préparer à tout est parfois raisonnable : on ne peut pas se prémunir contre tous les scénarios, et la préparation a un coût. Le biais commence quand la décision n'est pas prise sciemment, par comparaison des coûts et des effets.
- Le biais rétrospectif guette l'inverse : après coup, l'incident paraît « évident » (voir le biais rétrospectif). Évitez de juger sévèrement la décision d'hier avec les informations d'aujourd'hui.
- Dans les deux incidents cités, l'attribution au biais de normalité est une interprétation : les analyses publiées décrivent des défaillances techniques et organisationnelles, pas l'état d'esprit des personnes.
Sources et vérification#
- Omer & Alon (1994), « The continuity principle: A unified approach to disaster and trauma », American Journal of Community Psychology — le « principe de continuité ».
- GitLab (2017), « Postmortem of database outage of January 31 » — chronologie, volumes, échec des sauvegardes.
- Netcraft (mars 2021), « 3.6 million websites taken offline after fire at OVH datacenters » — 3,6 millions de sites, 464 000 domaines.
- Siècle Digital (10 mars 2021), compte rendu de l'incendie de Strasbourg
Voir aussi#
Se combine avec, ou renforce#
Ces biais se nourrissent l’un l’autre.
Biais voisins#
Des variantes ou des cousins : à ne pas confondre.
Contrepoids et réflexes associés#
Ce qui le neutralise.
- Le pré-mortem
- Les exercices de reprise (restauration testée) (notion ou méthode, sans fiche)
- L'ingénierie du chaos (notion ou méthode, sans fiche)
